Data Analytics | Insights & Research

PUAY101

Category: Statistics

  • EP.2: ผลตรวจเป็นบวก! สรุปว่าเราป่วยจริงไหม? – ไขปมความน่าจะเป็นแบบมีเงื่อนไข

    EP.2: ผลตรวจเป็นบวก! สรุปว่าเราป่วยจริงไหม? – ไขปมความน่าจะเป็นแบบมีเงื่อนไข

    ซีรีส์: Probability for Data Folks | เมื่อโค้ดไขความลับความน่าจะเป็น

    ในตอนที่แล้ว เราได้เห็นพลังของ กฎว่าด้วยจำนวนมาก (Law of Large Numbers) ที่พิสูจน์ว่ายิ่งทดลองซ้ำๆ ผลลัพธ์ก็จะยิ่งวิ่งเข้าหาทฤษฎี

    แต่ความน่าจะเป็นในโลกจริงนั้นซับซ้อนกว่าการโยนเหรียญ มันมักจะมาพร้อมกับ “เงื่อนไข” และข้อมูลแวดล้อมที่อาจทำให้เข้าใจผิดได้

    ลองจินตนาการถึงสถานการณ์นี้ครับ…

    สมมติว่ามีโรคหายากโรคหนึ่ง ซึ่งมีคนป่วยแค่ 1% ของประชากรทั้งหมด โชคดีที่มีชุดตรวจที่แม่นยำมากๆ ถึง 99% วันหนึ่งคุณไปตรวจสุขภาพ และได้รับผลว่า “เป็นบวก”

    คำถาม: เราสามารถสรุปได้เลยว่าโอกาสที่คุณจะป่วยเป็นโรคนั้นจริงๆ คือ 99% ได้ไหม?

    ถ้าคุณตอบว่า “ใช่” หรือ “ใกล้เคียง 99%”… คุณคือคนส่วนใหญ่ที่ตกหลุมพรางของสัญชาตญาณครับ คำตอบที่แท้จริงอาจจะน้อยกว่าที่คุณคิดไปไกลลิบเลยทีเดียว

    ปรากฏการณ์นี้คือหัวใจของ ความน่าจะเป็นแบบมีเงื่อนไข (Conditional Probability) ซึ่งเป็นแนวคิดที่สำคัญอย่างยิ่งในโลกของ Data Science และวันนี้เราจะมาไขความลับข้อนี้กัน

    มาวิเคราะห์โจทย์กันก่อน (The Devil is in the Details)

    ปัญหานี้ซับซ้อนกว่าการโยนเหรียญ เพราะมีข้อมูลหลายส่วนที่เราต้องทำความเข้าใจให้ชัดเจน:

    1. ความชุกของโรค (Base Rate หรือ Prevalence): มีคนป่วยแค่ 1% ของประชากรทั้งหมด (หรือ 0.01) นี่คือข้อมูลสำคัญที่คนมักจะมองข้าม
    2. ความแม่นยำของชุดตรวจ (Accuracy): 99% แต่คำว่า “แม่นยำ” ต้องแยกเป็น 2 กรณี
      • ถ้าคุณป่วยจริงๆ ชุดตรวจจะบอกว่า “บวก” ถูกต้อง 99% (True Positive Rate) และจะพลาดบอกว่า “ลบ” แค่ 1% (False Negative Rate)
      • ถ้าคุณไม่ป่วยจริงๆ ชุดตรวจจะบอกว่า “ลบ” ถูกต้อง 99% (True Negative Rate) และจะพลาดบอกว่า “บวก” แค่ 1% (False Positive Rate)

    คำถามของเราคือ P(textป่วย∣textผลเป็นบวก) หรือ “ความน่าจะเป็นที่จะป่วย เมื่อได้รับเงื่อนไขว่า ผลตรวจเป็นบวก”

    คิดแบบไม่ใช้สูตร: ลองจินตนาการถึงคน 100,000 คน

    การคำนวณด้วยสูตรอาจจะน่าปวดหัว งั้นเรามาใช้วิธีที่ “จับต้องได้” ที่สุดกันครับ ลองจินตนาการว่าเรามีประชากรอยู่ 100,000 คน

    Step 1: ใน 100,000 คนนี้ มีคนป่วยกี่คน? จากความชุกของโรค 1% หมายความว่า:

    • คนป่วยจริงๆ: 100,000 * 1% = 1,000 คน
    • คนที่ไม่ป่วย: 100,000 – 1,000 = 99,000 คน

    Step 2: เอาคนป่วย 1,000 คนไปตรวจ จากความแม่นยำ 99% ของชุดตรวจ:

    • ผลตรวจเป็น “บวก” (และป่วยจริง – True Positive): 1,000 * 99% = 990 คน
    • ผลตรวจเป็น “ลบ” (ทั้งที่ป่วยจริง – False Negative): 1,000 * 1% = 10 คน

    Step 3: เอาคนที่ไม่ป่วย 99,000 คนไปตรวจ นี่คือจุดที่สำคัญที่สุด! แม้คนเหล่านี้จะไม่ป่วย แต่ชุดตรวจก็มีโอกาสพลาดได้ 1%:

    • ผลตรวจเป็น “บวก” (ทั้งที่ไม่ป่วย – False Positive): 99,000 * 1% = 990 คน
    • ผลตรวจเป็น “ลบ” (และไม่ป่วยจริง – True Negative): 99,000 * 99% = 98,010 คน

    Step 4: หาคำตอบ! ตอนนี้เรามาตอบคำถามเดิมกัน: “ถ้าผลตรวจของคุณเป็นบวก โอกาสที่คุณจะป่วยจริงๆ เป็นเท่าไหร่?”

    • ก่อนอื่น มาดูกลุ่มคนที่ได้ผล “บวก” ทั้งหมดกันก่อน ซึ่งมาจาก 2 กลุ่ม:
      • คนที่ป่วยจริงและผลเป็นบวก: 990 คน
      • คนที่ไม่ป่วยแต่ผลเป็นบวก: 990 คน
      • รวมคนที่มีผลตรวจเป็นบวกทั้งหมด = 990 + 990 = 1,980 คน
    • ในบรรดา 1,980 คนที่เดินออกจากห้องตรวจพร้อมผล “บวก” นี้ มีคนที่ป่วยจริงๆ กี่คน?
      • คำตอบคือ 990 คน (กลุ่ม True Positive)

    ดังนั้น ความน่าจะเป็นที่จะป่วยจริง เมื่อผลตรวจเป็นบวก คือ:

    ใช่แล้วครับ… 50% เท่านั้น! น่าตกใจใช่ไหมครับ? แม้ชุดตรวจจะแม่นยำถึง 99% แต่โอกาสที่คุณจะป่วยจริงๆ กลับมีแค่ 50% เหตุผลก็เพราะโรคนี้มัน “หายาก” มากๆ ทำให้จำนวนคนที่ “ไม่ป่วยแต่ดันได้ผลบวก” (False Positive) มีจำนวนพอๆ กับคนที่ “ป่วยและได้ผลบวก” (True Positive) เลยทีเดียว

    ให้ Code พิสูจน์ความจริง

    ตอนนี้เรามาสร้าง Simulation ด้วย Python เพื่อยืนยันแนวคิดที่หักมุมนี้กันครับ เราจะสร้างประชากรเสมือนจริง 1 ล้านคน แล้วจำลองการตรวจโรคทั้งหมด

    Python

    import random
    # 1. Setup the parameters of our world
    population_size = 1_000_000
    disease_prevalence = 0.01 # 1% of the population is sick
    test_accuracy = 0.99 # 99% accuracy
    # For clarity in simulation
    true_positive_rate = test_accuracy
    false_positive_rate = 1 – test_accuracy
    # 2. Create lists to hold our results
    # We will store tuples of (is_sick, test_result)
    population_data = []
    # 3. Simulate the entire population
    for i in range(population_size):
    # Determine if this person is sick based on prevalence
    is_sick = (random.random() < disease_prevalence)
    test_result = ''
    if is_sick:
    # It's a sick person, use the true positive rate
    if random.random() < true_positive_rate:
    test_result = 'Positive'
    else:
    test_result = 'Negative'
    else:
    # It's a healthy person, use the false positive rate
    if random.random() < false_positive_rate:
    test_result = 'Positive'
    else:
    test_result = 'Negative'
    population_data.append((is_sick, test_result))
    # 4. Analyze the results
    total_positives = 0
    true_positives = 0
    for person in population_data:
    is_sick, test_result = person
    if test_result == 'Positive':
    total_positives += 1
    if is_sick: # and they are actually sick
    true_positives += 1
    # 5. Calculate the final conditional probability
    # Handle the case where total_positives might be zero
    if total_positives > 0:
    conditional_probability = true_positives / total_positives
    else:
    conditional_probability = 0
    print(f"Simulation based on {population_size:,} people:")
    print(f"Total people who tested 'Positive': {total_positives:,}")
    print(f"People who are actually sick AND tested 'Positive': {true_positives:,}")
    print("-" * 30)
    print(f"The probability of being sick given a positive test is: {conditional_probability:.4f}")
    view raw ep2.py hosted with ❤ by GitHub

    Result:

    Simulation based on 1,000,000 people:
    Total people who tested 'Positive': 19,891
    People who are actually sick AND tested 'Positive': 9,933
    ------------------------------
    The probability of being sick given a positive test is: 0.4994
    

    ผลลัพธ์จาก Code ยืนยันสิ่งที่เราคำนวณด้วยมืออย่างชัดเจน! ความน่าจะเป็นที่ได้เข้าใกล้ 0.5 หรือ 50% อย่างไม่น่าเชื่อ

    เรื่องนี้เกี่ยวกับ Data Science อย่างไร?

    สิ่งที่เราเพิ่งทำไปคือการประยุกต์ใช้แนวคิดของ ทฤษฎีของเบย์ (Bayes’ Theorem) ซึ่งเป็นหนึ่งในเครื่องมือที่สำคัญที่สุดของ Data Scientist สูตรของมันคือ:

    โดยที่:

    • P(A∣B) คือสิ่งที่เราอยากรู้ (โอกาสป่วย เมื่อผลบวก)
    • P(B∣A) คือความแม่นยำของเทส (โอกาสผลบวก เมื่อป่วย)
    • P(A) คือความชุกของโรค (โอกาสที่จะป่วยตั้งแต่แรก)
    • P(B) คือโอกาสทั้งหมดที่จะได้ผลบวก

    หลักการนี้ถูกนำไปใช้ในหลายๆ ที่:

    • Spam Filters: คำนวณความน่าจะเป็นที่อีเมลจะเป็น “สแปม” เมื่อ มันมีคำว่า “โปรโมชั่น” หรือ “ฟรี”
    • Recommendation Engines: แนะนำสินค้าโดยคำนวณความน่าจะเป็นที่ลูกค้าจะ “ชอบสินค้า A” เมื่อ พวกเขาเคย “ซื้อสินค้า B” มาก่อน
    • A/B Testing: ประเมินความน่าจะเป็นว่า “เวอร์ชัน B ดีกว่า” เมื่อ เราได้ “เห็นข้อมูลผลลัพธ์” แบบนี้

    บทสรุปสุดท้าย

    • บทเรียนสำคัญที่สุดในวันนี้คือ “อย่าลืม Base Rate” หรือข้อมูลพื้นฐานเริ่มต้น
    • ความน่าจะเป็นแบบมีเงื่อนไขสอนให้เรามองภาพรวมและไม่ด่วนสรุปจากข้อมูลเพียงชิ้นเดียว

    สุดท้าย>>ขอขอบคุณทุกๆคนเลยครับที่อ่านจนมาถึงตรงนี้หวังว่าจะชอบกันนะครับ

    ในตอนหน้าของซีรีส์… เราจะไปคำนวณ “ความสิ้นหวัง” ที่ทุกคนคุ้นเคยกันดีในหัวข้อ: “EP.3: ทำไมเราถึงไม่เคยถูกหวย”

    ฝากติดตามตอนต่อไปด้วยนะคร้าบบ 😁😁😁

  • EP.1: โยนเหรียญทายใจคอม – ความน่าจะเป็น 101 ที่พิสูจน์ได้ด้วย Code

    EP.1: โยนเหรียญทายใจคอม – ความน่าจะเป็น 101 ที่พิสูจน์ได้ด้วย Code

    ซีรีส์: Probability for Data Folks | เมื่อโค้ดไขความลับความน่าจะเป็น

    “ถ้าเราโยนเหรียญ 10 ครั้ง จะออกหัวกี่ครั้ง?”

    คำตอบแรกที่แวบเข้ามาในหัวของคนส่วนใหญ่ก็คือ “5 ครั้ง” ซึ่งก็สมเหตุสมผลดี เพราะเราทุกคนต่างเรียนมาว่าโอกาสที่เหรียญจะออก”หัว”หรือ”ก้อย” มันเท่ากัน คือ 50/50

    แต่ในโลกความจริง… ถ้าเราลองหยิบเหรียญมาโยน 10 ครั้งจริงๆ ผลลัพธ์อาจจะเป็น หัว 6 ก้อย 4 หรือบางทีอาจจะสุดโต่งไปทาง หัว 8 ก้อย 2 เลยก็ได้ แล้วแบบนี้… ไอ้ทฤษฎี 50% ที่เราเชื่อมั่นกัน มันจะเชื่อถือได้แค่ไหนกัน?

    ถ้าจะให้พิสูจน์เรื่องนี้ด้วยการนั่งโยนเหรียญเป็นพันๆ หมื่นๆ ครั้งคงเป็นเรื่องที่น่าเบื่อและเสียเวลา..ในบทความนี้เราเลยจะมา Simulation การโยนเหรีญ ขึ้นมา โดยใช้ Python

    ในบทความแรกของซีรีส์นี้ เราจะเปลี่ยนคอมพิวเตอร์ของเราให้กลายเป็น “ห้องทดลองความน่าจะเป็น” เพื่อตอบคำถามง่ายๆ ที่ทรงพลังข้อนี้กันครับ

    ทบทวนความน่าจะเป็น

    ก่อนจะไปเขียน Code เรามาทบทวนความเข้าใจกันสักนิด ความน่าจะเป็น (Probability) ถ้าจะพูดแบบบ้านๆ ที่สุด มันคือ “ตัวเลขที่ใช้วัด ‘ความเชื่อ’ ของเราว่าเหตุการณ์นั้นๆ มีโอกาสเกิดขึ้นมากน้อยแค่ไหน”

    โดยตัวเลขนี้จะวิ่งอยู่ระหว่าง 0 ถึง 1 เท่านั้น:

    • 0 หมายถึง ไม่มีทางเกิดขึ้นแน่นอน
    • 1 หมายถึง เกิดขึ้นแน่นอน 100%

    สำหรับเหรียญของเรา การโยน 1 ครั้งมีผลลัพธ์ที่เป็นไปได้ทั้งหมด 2 แบบ คือ ‘หัว’ (Heads) กับ ‘ก้อย’ (Tails) ดังนั้น โอกาสที่จะออก ‘หัว’ จึงคำนวณได้ง่ายๆ ว่า:

    นี่คือ “ความน่าจะเป็นตามทฤษฎี” (Theoretical Probability) ที่เราท่องจำกันมา และก็ถึงเวลามาพิสูจน์ด้วยการทดลองแล้วครับ

    Hands-on Python

    เราจะใช้ไลบรารีพื้นฐานของ Python ที่ชื่อว่า random ซึ่งมีติดมาให้อยู่แล้ว ไม่ต้องติดตั้งอะไรเพิ่มเติม (ใน Code เราจะใช้คำว่า Heads แทน ‘หัว’ และ Tails แทน ‘ก้อย’ )

    ขั้นตอนที่ 1: จำลองการโยนเหรียญ 1 ครั้ง

    เปิดโปรแกรมเขียน Python ของคุณขึ้นมา แล้วลองพิมพ์ตามนี้ได้เลย:

    import random
    # Possible outcomes of a coin flip
    outcomes = ['Heads', 'Tails']
    # Randomly choose one from the outcomes
    result = random.choice(outcomes)
    print(f"Single coin flip result: {result}")
    view raw s_1.py hosted with ❤ by GitHub
    --Result--
    Single coin flip result: Tails 

    ทุกครั้งที่คุณรัน Code ชุดนี้ ผลลัพธ์ก็จะสลับไปมาระหว่าง ‘Heads’ กับ ‘Tails’ ง่ายๆ แค่นี้เลยครับ! เราเพิ่งจำลองการโยนเหรียญครั้งแรกสำเร็จแล้ว

    ขั้นตอนที่ 2: จำลองการโยนเหรียญ 10,000 ครั้ง!

    การโยนครั้งเดียวมันยังไม่เห็นภาพ งั้นเรามาสั่งให้คอมพิวเตอร์โยนเหรียญให้เราสัก 10,000 ครั้ง แล้วนับดูสิว่ามันออก ‘Heads’ ไปกี่ครั้ง

    import random
    # 1. Setup the experiment
    total_flips = 10000
    head_counts = 0
    outcomes = ['Heads', 'Tails']
    # 2. Start the simulation loop
    for _ in range(total_flips):
    # In each loop, simulate one flip
    result = random.choice(outcomes)
    # 3. Check the result and increment the counter if it's 'Heads'
    if result == 'Heads':
    head_counts += 1
    print(f"Total flips: {total_flips}")
    print(f"Total 'Heads' results: {head_counts}")
    view raw s_2.py hosted with ❤ by GitHub
    --Result--
    Total flips: 10000
    Total 'Heads' results: 4928

    และแล้ว… ผลลัพธ์ก็ปรากฏ

    หลังจากรัน Code ด้านบนแล้ว เรามีจำนวนครั้งที่โยนทั้งหมด (total_flips) และจำนวนครั้งที่ออกหัว (head_counts) อยู่ในมือ สิ่งที่เราต้องทำต่อก็คือการคำนวณ “ความน่าจะเป็นที่ได้จากการทดลอง”

    มาเพิ่ม Code อีกนิดหน่อยเพื่อดูผลลัพธ์กันฮะ:

    import random
    # 1. Setup the experiment
    total_flips = 10000
    head_counts = 0
    outcomes = ['Heads', 'Tails']
    # 2. Start the simulation loop
    for _ in range(total_flips):
    # In each loop, simulate one flip
    result = random.choice(outcomes)
    # 3. Check the result and increment the counter if it's 'Heads'
    if result == 'Heads':
    head_counts += 1
    print(f"Total flips: {total_flips}")
    print(f"Total 'Heads' results: {head_counts}")
    view raw s_2.py hosted with ❤ by GitHub
    Total flips: 10000
    Total 'Heads' results: 4987
    Simulated probability of Heads is: 0.4987

    สังเกตุว่าตัวเลข 0.4987 ที่ได้ ใกล้เคียงกับ 0.5 ตามทฤษฎีของเราอย่างไม่น่าเชื่อ

    นี่คือหัวใจสำคัญที่เราอยากแสดงให้เห็นในวันนี้ ปรากฏการณ์นี้มีชื่อเรียกเท่ๆ ว่า กฎว่าด้วยจำนวนมาก (Law of Large Numbers) ซึ่งกล่าวไว้ว่า:

    “ยิ่งเราทำการทดลองแบบสุ่มซ้ำๆ เป็นจำนวนมากเท่าไหร่ ผลลัพธ์เฉลี่ยที่ได้จากการทดลอง ก็จะยิ่งวิ่งเข้าใกล้ค่าที่คาดหวังตามทฤษฎีมากขึ้นเท่านั้น”

    พูดง่ายๆ ก็คือ การโยนเหรียญแค่ 10 ครั้งอาจจะดู “มั่ว” แต่ถ้าโยนเป็นหมื่นเป็นแสนครั้ง ความ “มั่ว” นั้นจะค่อยๆ หายไป และผลลัพธ์จะลู่เข้าหาความจริงตามทฤษฎี

    แล้วเรื่องนี้มันสำคัญยังไง? 🤔

    คุณอาจจะคิดว่า “ก็แค่เรื่องโยนเหรียญ… แล้วมันไปเกี่ยวกับ Data Science ตรงไหน?”

    จริงๆ แล้วนี่คือหลักการพื้นฐานที่ทรงพลังมาก:

    • A/B Testing: เวลาบริษัทเทคฯ อยากรู้ว่าปุ่มสีเขียวกับสีแดง ปุ่มไหนมีคนคลิกมากกว่ากัน พวกเขาจะปล่อยให้คนเป็นหมื่นเป็นแสนคนใช้งาน แล้วดูผลลัพธ์ มันคือหลักการเดียวกับที่เราโยนเหรียญเป็นหมื่นครั้งนี่แหละครับ
    • บริษัทประกัน: บริษัทประกันไม่รู้หรอกว่า “นาย ก.” จะป่วยเมื่อไหร่ แต่พวกเขามีข้อมูลคนเป็นล้านๆ คน (เหมือนการทดลองจำนวนมาก) ทำให้สามารถ “ทำนาย” ได้อย่างแม่นยำว่าในภาพรวมแล้วจะมีคนป่วยกี่คน เพื่อคำนวณเบี้ยประกันได้อย่างเหมาะสม
    • การสร้างแบบจำลอง: เทคนิคการจำลองแบบนี้คือพื้นฐานของ “Monte Carlo Simulation” ซึ่งเป็นเครื่องมือที่ Data Scientist ใช้จำลองสถานการณ์ที่ซับซ้อนมากๆ เช่น การคาดการณ์ราคาหุ้น หรือความเสี่ยงของพอร์ตการลงทุน

    บทสรุป🚀

    วันนี้ เราได้เปลี่ยนคำถามง่ายๆ เกี่ยวกับการโยนเหรียญ ให้กลายเป็นการทดลองที่จับต้องได้ด้วย Python เราได้พิสูจน์แนวคิดพื้นฐานของความน่าจะเป็น และได้เห็นกฎว่าด้วยจำนวนมาก (Law of Large Numbers) ทำงานให้เห็นกับตา

    Challenge สำหรับคุณ: ลองคัดลอก Code ด้านบนไปเล่นดูครับ

    1. เปลี่ยนค่า total_flips ให้เป็น 100, 1,000, 1,000,000 แล้วดูสิว่าผลลัพธ์ที่ได้มันเข้าใกล้ 0.5 มากขึ้นเรื่อยๆ จริงไหม
    2. ลองปรับ Code เพื่อจำลอง “การทอยลูกเต๋า” (dice roll) 1 ลูก แล้วดูว่าโอกาสที่จะได้เลข 6 เข้าใกล้ 1/6 (ประมาณ 0.1667) หรือเปล่า

    ในตอนหน้าของซีรีส์ เราจะไปเจอกับปัญหาที่ซับซ้อนและสนุกยิ่งกว่านี้ในหัวข้อ: “EP.2: ผลตรวจเป็นบวก! สรุปว่าเราป่วยจริงไหม?” ฝากติดตามด้วยนะครับบ

  • หาความสัมพันธ์ของตัวแปร Categorical ด้วย  Chi-square test

    หาความสัมพันธ์ของตัวแปร Categorical ด้วย Chi-square test

    อย่างที่รู้กันว่าการที่เราอยากจะหาความสัมพันธ์ของ Quantitative variable (เช่น: รายได้ กับ IQ มีความสัมพันธ์เป็นยังไงกัน) เราสามารถใช้ Pearson-correlation เพื่อหาความสัมพันธ์ได้

    แต่ถ้าข้อมูลของเราเป็น Categorical ที่ไม่ใช่ตัวเลขจะหาความสัมพันธ์ได้ไหม

    คำตอบคือได้ครับ แต่ก่อนอื่นต้องทำความเข้าใจก่อนว่าข้อมูลประเภท Categorical คืออะไร

    คำจำกัดความ: ตัวแปรเชิงหมวดหมู่ (categorical variable) คือ ตัวแปรที่ใช้ชนิดของข้อมูลที่แบ่งแยกเป็นกลุ่มหรือหมวดหมู่ โดยไม่สามารถแสดงเป็นค่าตัวเลขที่มีความสัมพันธ์เชิงปริมาณ

    Categorical variable แบ่งออกแป็น 2 แบบ

    • Ordinal
    • Norminal

    Ordinal คือ ตัวแปรที่มีมีลำดับชนชั้นต่อกันอย่างเช่น ประสบการณ์การทำงาน, อายุ, ระดับการศึกษา,ระดับความพึงพอใจ

    Norminal คือตัวแปรที่มีความเป็นอิสระ ไม่มีลำดับชนชั้นแบบ Ordinal ยกตัวอย่างเช่น คำตอบ(ใช่ หรือ ไม่), สีที่ชอบ, ประเทศ, จังหวัด


    ในบทความนี้จะเน้นไปที่การหาความสัมพันธ์ของ Norminal variable

    .

    .

    .

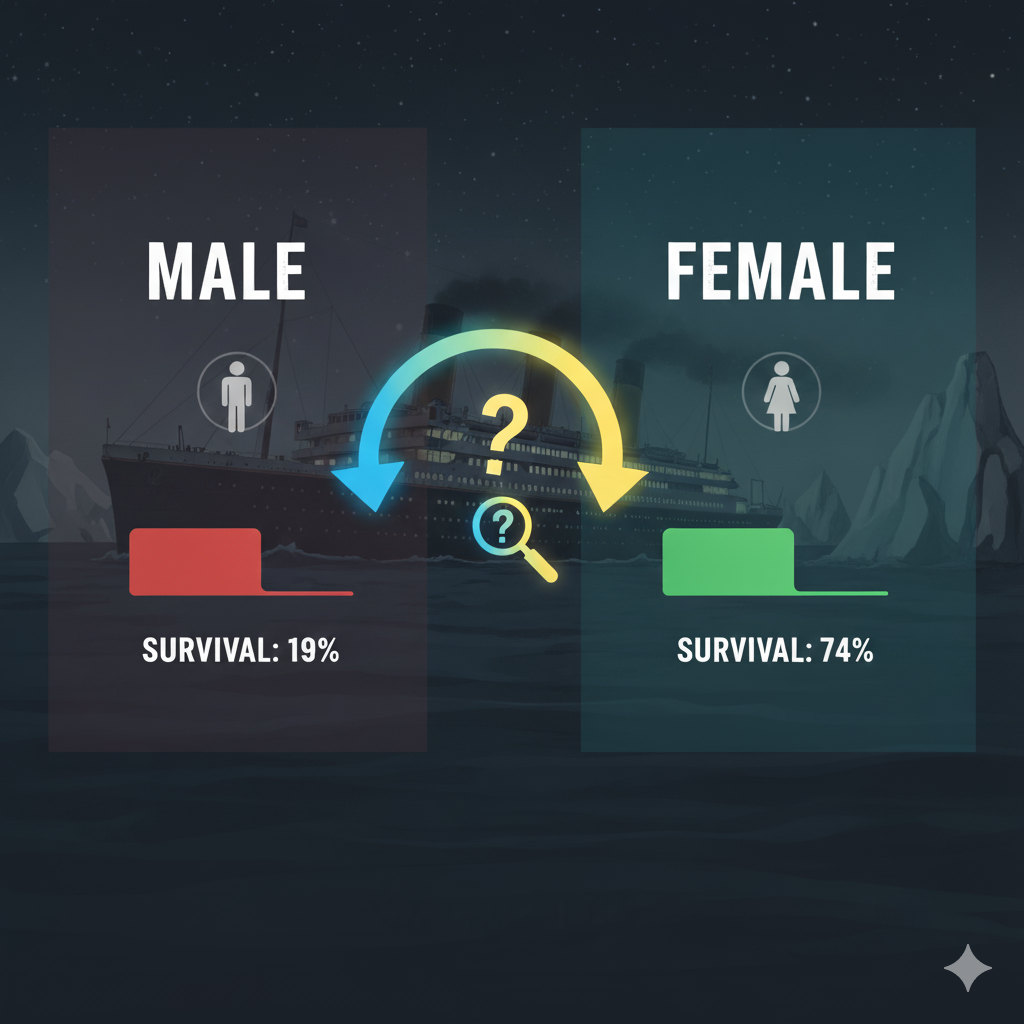
    “เพศมีผลต่ออัตราการรอดตายไหม! ในสถานการณ์เรือไททานิคล่ม”

    เพื่อหาคำตอบ เราจะใช้เครื่องมือทางสถิติที่เรียกว่า ตารางการพิจารณาร่วม (Contingency Table) ซึ่งช่วยให้เราเห็นภาพรวมว่าคนแต่ละกลุ่ม (เช่น หญิงกับชาย) มีผลลัพธ์ที่ต่างกันอย่างไร เช่น รอดหรือไม่รอด โดยใช้โปรแกรม R ในการวิเคราะห์


    Contingency Table คืออะไร

    เวลาที่เรามี Categorical อย่างเช่น ชาย-หญิง หรือ เด็ก-ผู้ใหญ่,รอด-ไม่รอด)เป็นตารางความถี่ อย่างในรูปนี้

    เราสนใจตัวแปร Sex กับ Survived ซึ่งเป็น Nominal ทั้งคู่

    แปลงเป็นตารางความถี่

    จะเห็นว่า จำนวนผู้ชายเสียชีวิตมากกว่าผู้หญิง

    แต่ การที่มีผู้ชายเสียชีวิตมากกว่าผู้หญิงบอกอะไรได้บ้าง

    แสดงว่าผู้หญิงจะมีโอกาศรอดตายมากกว่าผู้ชาย ?

    จะบอกแบบนี้ก็ยังไม่ถูกครับ..เราจะมาดูกันว่า 2 ตัวแปรนี้มีความสัมพันธ์กันจริงๆไหม โดยใช้ Chi-square test กันครับ

    ถามว่าผู้ชายกับผู้หญิง มีความสัมพันธ์ กับการรอดชีวิตหรือป่าว

    อย่างแรกเราก็ต้องทำให้สิ่งที่เราสนใจออกมาเป็นรูปแบบตารางไขว้ หรือ contingency table กันก่อน ถ้าเป็นใน R ใช้ table() หรือ xtab()

    xtabs(Freq~Sex+Survived,df)

    Expected Value

    สิ่งที่ได้หลังจากเราสร้าง Contingency ก็คือความถี่ของทั้ง 2 ตัวแปรที่ไขว้กันอยู่ ดั่งในรูป

    โดยที่ คนบนเรือทั้งหมด N= 2201

    จำนวนผู้ชายทั้งหมด n(Male)=1731

    และ ผู้หญิง n(Famale)= 470

    คนรอดชีวิตn(Yes) =711

    ไม่รอดชีวิต n(No)=1490

    *** มาคำนวน Expected Value ของแต่ละตัวกัน Expected Value ต่อไปนี้จะใช้ ตัวย่อว่า E(X)แทนนะครับ

    E(Male and No) = n(Male) * n(No)/N = 1731 * 1490 /2201 = 1171.826

    E(Male and Yes) = n(Male) * n(Yes)/N = 1731 * 711 /2201 = 559.1736

    E(Female and No) = n(Female) * n(No)/N = 470 * 1490 /2201 = 318.1736

    E(Female and Yes) = n(Female) * n(Yes)/N = 470 * 711 /2201 = 151.8264

    Expected value ที่เราเพิ่งคำนวณไปคือค่าที่บอกว่า “ถ้าเหตุการณ์ทั้งสอง เป็นอิสระต่อกัน (Independence) มันควรจะมีค่าเป็นเท่าไหร่ ” นี่คือหัวใจสำคัญของ Chi-Square เลย

    สมมติฐานของ Chi-Square Test of Independence บอกไว้ว่า:

    • H0: (null hypothesis) The two variables are independent.
    • H1: (alternative hypothesis) The two variables are not independent. (i.e. they are associated)

    กล่าวคือถ้าเราเทียบค่าจริงกับค่าที่ควรจะเป็น(Expected)แล้วมันไม่ต่างกันมากเราก็สรุปได้ว่า : ตัวแปร 2 ตัวมีความเป็นอิสระต่อกัน

    ในทางตรงข้าม ถ้าเกิดมี Diff ระหว่าง Expected กับ ค่าจริงมากเกินไป จะทำให้เราต้องปฏิเสธ สมมติฐานหลัก (Reject null hypothesis) สรุปคือ : ตัวแปร 2 ตัวมีความสัมพันธ์ต่อกัน

    .

    แล้วเราจะรู้ได้ยังไงว่าต่างกันแค่ไหนถึงเรียกได้ว่าไม่เป็นอิสระ(Dependence) หรือแตกต่างกันน้อยแค่ไหนจึงจะเป็นอิสระ (Independence)

    .

    หลักการในการวัดของ Chi-square ก็คือ square ตามชื่อเลย (ลืมบอกไปว่า Chi-Square เรียกอีกชื่อคือ X2) :

    เห็นสมการนี้แล้วก็อย่างเพิ่งสับสนไปครับ ตารางข้างล่างจะ คำนวณให้ดู Step By Step

    O =ค่าจริงที่เรามี

    E =ค่า Expected ที่เราคำนวณไว้ก่อนหน้านี้

    เขียนอีกแบบคือ

    เอาผลต่าง มายกกำลัง 2 แล้วหารด้วย Expected Value

    SexY/NOEXX2X2/E
    MNo13641172192.13693031
    FNo126318-192.136930116
    MYes367559-192.13693066
    FYes344152192.136930243

    จากนั้นก็ Sum Column สุดท้ายเข้าด้วยกัน ก็จะได้ค่า Chi-square นั้นเอง

    31+116+66+243 =456
    X2 = 456

    จำเลข 456 นี้ไว้

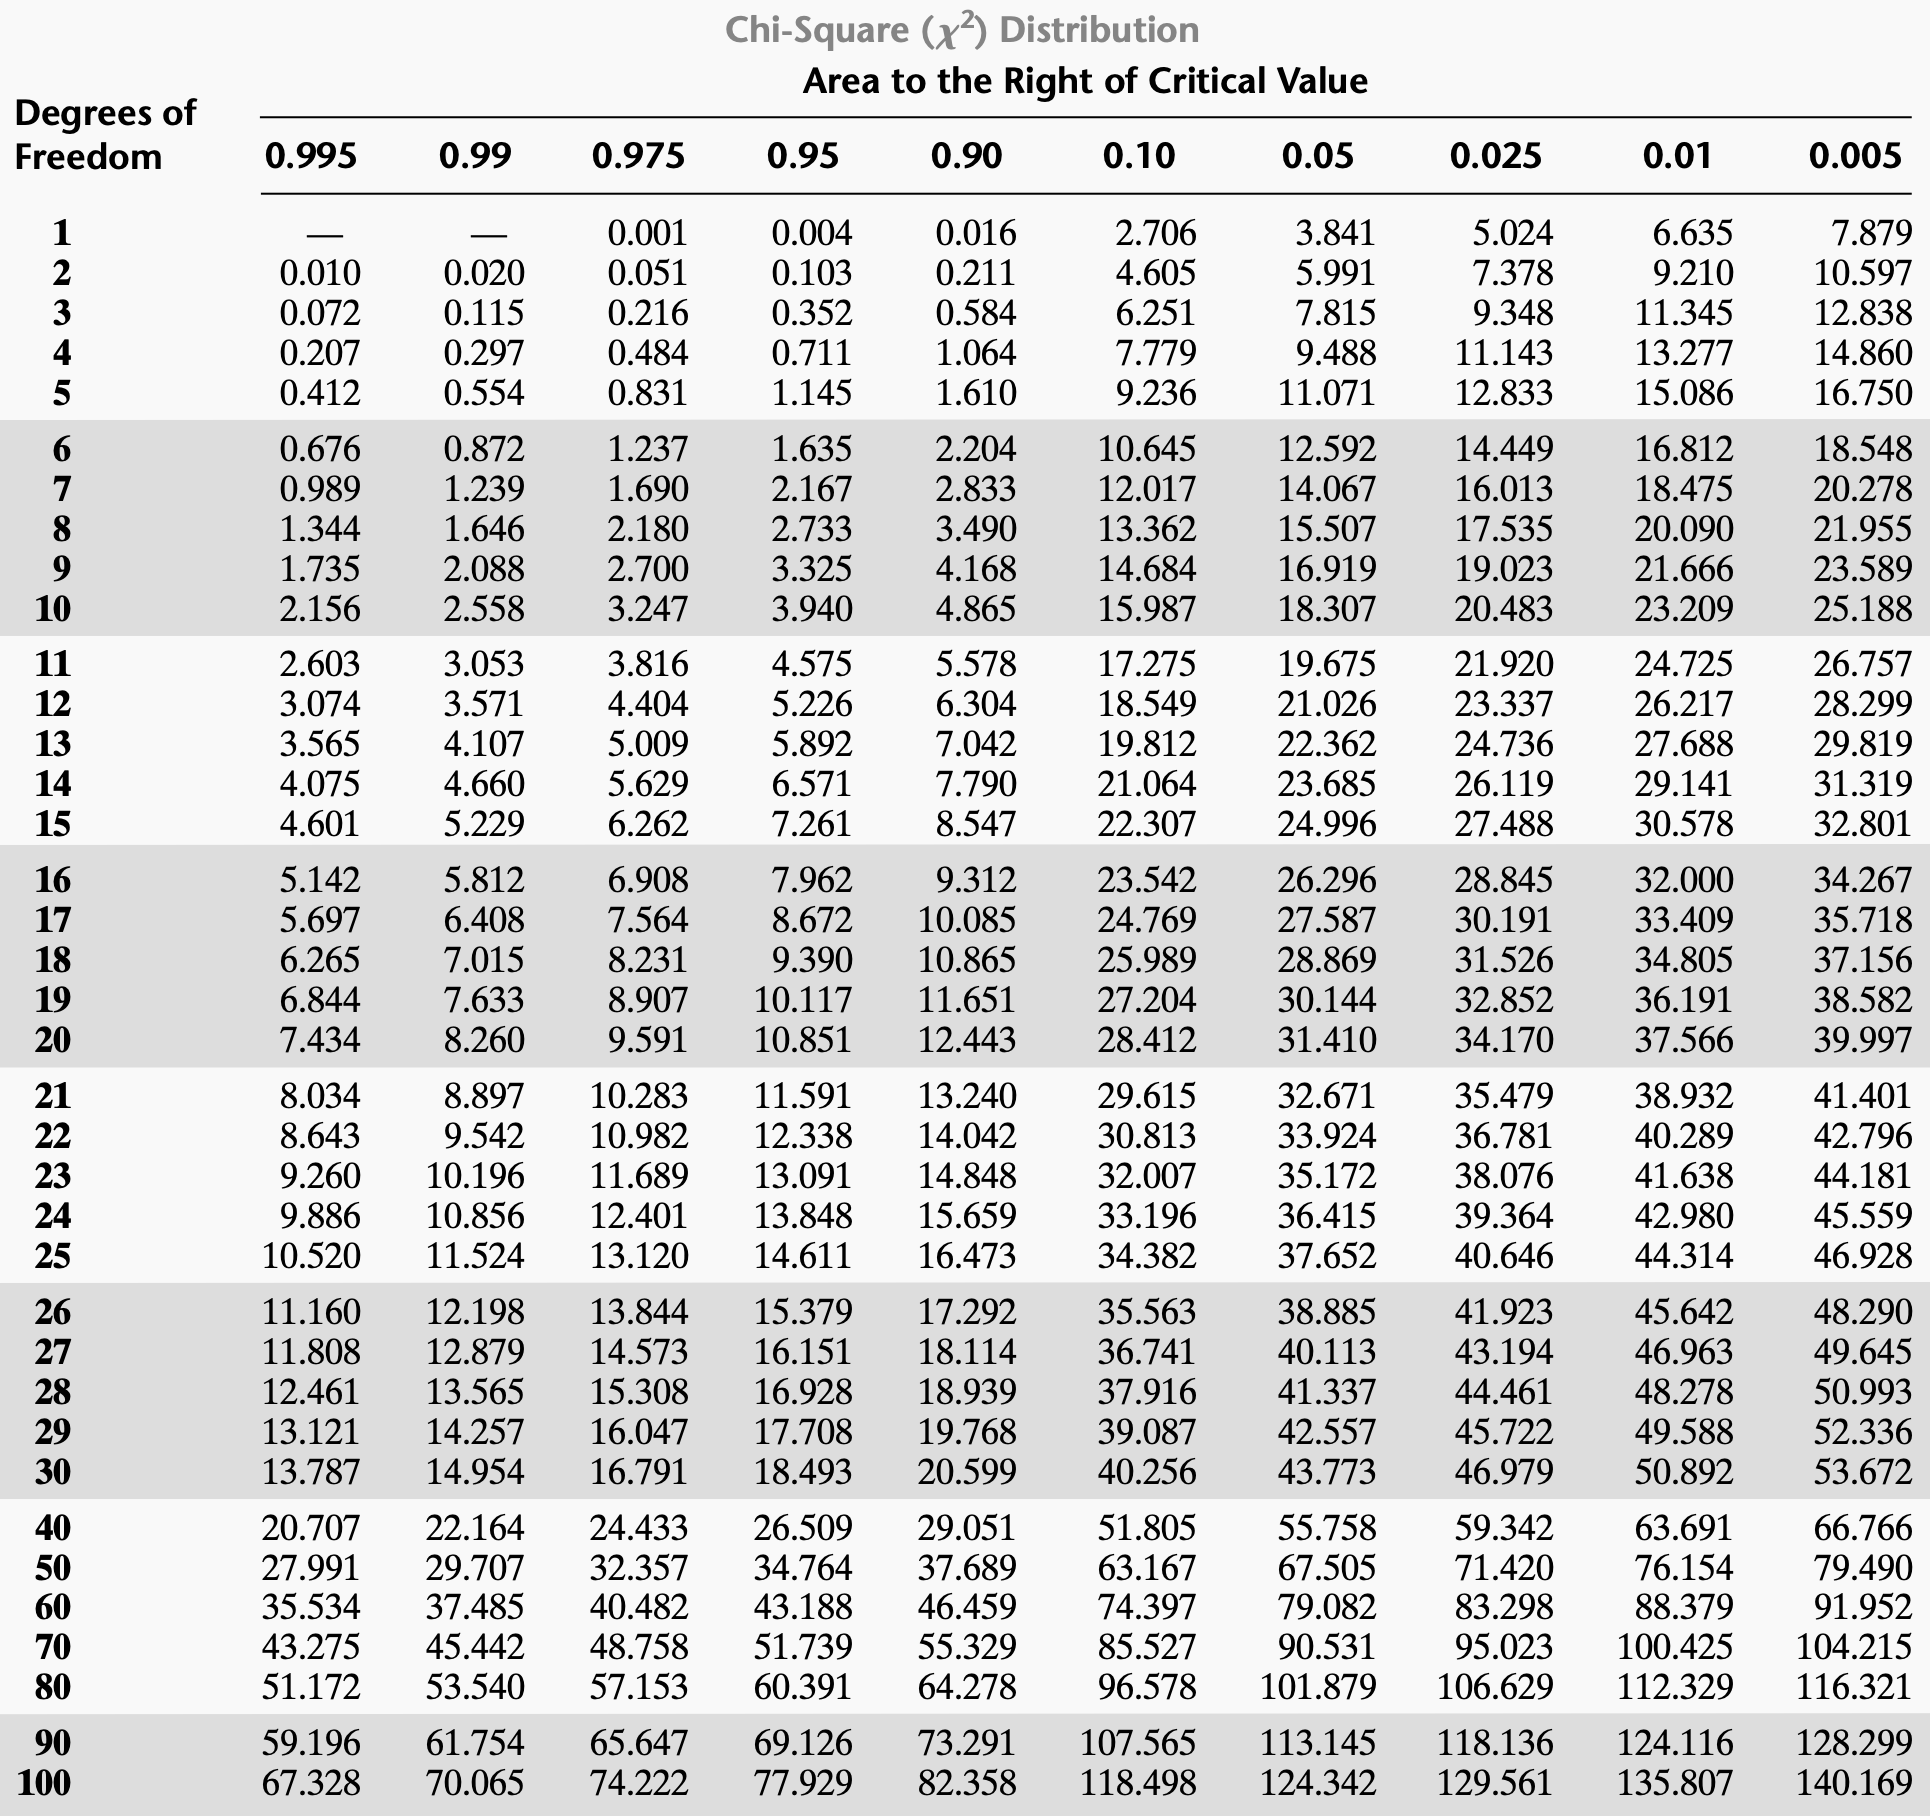
    แล้วเปิดตาราง Chi-square เพื่อหา Critical Region

    ตัวอย่างตาราง Chi-square

    ก่อนที่เราจะดูตารางเราต้องรู้ก่อนว่า Parameter แต่ละตัวของ ตารางที่มีอะไรบ้าง

    • Alpha (Default ของโปรแกรมสถิติคือ 0.05)
    • Degree of freedom = (r – 1) * (c – 1)
      • r : จำนวนแถว
      • c : จำนวนคอลลั่ม

    Table เราเป็น 2×2 matric (2 rows ,2columns)

    = (2-1) * (2-1) = 1

    ข้อควรระวัง: ให้ดูว่าตารางเป็น Left Hand หรือ Right Hand

    ถ้าตารางที่ดูเป็น Left Hand ให้เอา 1-Alpha

    ถ้าเป็น Right Hand ให้ใช้ค่า Alpha ได้เลย

    คราวนี้เปิดตารางที่ Alpha = 0.05 และ Df = 1

    จะได้ Tablealpha=0.05 df=1= 3.841

    เอาค่า Critical Value ที่ได้ ไปเทียบกับค่าที่คำนวนได้ก่อนหน้านี้

    จะเห็นได้ว่า ค่า X^2 >= Critical Value (แถบสีดำ)

    หมายความว่า ตัวแปร Categorical 2 ตัว Sex กับ Survived มีความสัมพันธ์กันอย่างมีนัยยะสำคัญทางสถิติ

    .

    ทุกคนที่อ่านจนมาถึงตรงนี้คงคิดว่า”ทำไมมันดูยุ่งยากจังใช่ไหมครับ”

    แต่จริงๆเราไม่ต้องมานั่งคำนวณอะไรแบบนี้เลย เพราะ ในโปรแกรม R

    มีฟังก์ชั่น Chisq.test แค่ใส่ Cotingency table ก็ได้การคำนวณที่เราคำนวณไว้ก่อนหน้านี้แล้วว

    m <- xtabs(Freq~Survived+Sex,Titanic)
    chisq.test(m)

    Result:

    
    	Pearson's Chi-squared test with Yates' continuity correction
    
    data:  m
    X-squared = 454.5, df = 1, p-value < 2.2e-16

    ค่า X-squared = 454.5 ใกล้เคียงกับที่คำนวนมาเลย ง่ายมากกก!!

    มีอีก1 วิธีดูคือ:

    ดูที่ค่า p-value ถ้าน้อยกว่าค่าalpha (0.05) แสดงว่าตัวแปร2ตัวมีความสัมพันธ์กัน

    ขอบคุณทุกๆคนที่สละเวลามาอ่านบทความนี้นะครับ 🙏🏻


    .

    .

    .

    ใครสนใจอ่านต่อผมแนะนำเว็ปนี้เลยคร้าบ Statistics by Jim – Statistics By Jim อธิบาย Basic Statistic ได้ดีมากๆ

    References

    Using Contingency Tables to Calculate Probabilities – Statistics By Jim

    Joint Probability: Definition, Formula & Examples – Statistics By Jim

    One response to “หาความสัมพันธ์ของตัวแปร Categorical ด้วย Chi-square test”

    1. jakkawat sukkasam Avatar

      Fc เลยครับพรี่

    Leave a Reply

  • ไอเดียที่ได้จาก Sprint: Statistic

    ไอเดียที่ได้จาก Sprint: Statistic

    What Is Statistic

    Statistic คือศาสตร์ที่เป็นการศึกษาจากกลุ่มตัวอย่าง(Sample)เพื่อมาอธิบายโลกความจริง(Population)

    Inductive reasoning is a specific observation to general conclusion”


    Sampling

    Sampling คือ การสุ่มตัวอย่างออกมาจากประชากรทั้งหมด โดย assume ว่าสามารถ represent ประชากรทั้งหมดได้

    ยิ่ง Sample เข้าใกล้ Population เท่าไหร่ Result ยิ่ง Accuracy มากขึ้น แต่ Sampling ในการทำงานถูกจำกัดอยู่ 2 อย่าง คือ Budget and Time

    Sampling’s Method

    แบ่งออกเป็น Probability Sampling และ Non-probability Sampling

    1. Probability Sampling 🎲 (Efficient ที่สุด)
      • Simple random sampling การสุ่มที่ต้องทำในระบบปิดคือที่ต้องมีรายชื่อประชากรทั้งหมดก่อน ทุกๆคนจะมีโอกาศถูกสุ่มได้เท่าๆกัน เช่น ล๊อตตารี่
      • Systematic random sampling สุ่มแบบเป็นระบบเช่น สุ่ม1เว้น2 เป็นต้น คือเราต้องกำหนด Rule Base ในการเลือกกลุ่มตัวอย่าง
      • Cluster random sampling แบ่ง Population ออกเป็น Cluster
      • Stratified random sampling (ใช้ในงาน Market research) Step แบ่ง Population ออกเป็น Region (และใช้ random sampling ใน region นั้นๆอีกที) → Survey ตามพื้นที่ → สรุปผล
    2. Non-Probability Sampling
      • Convenience ส่วนใหญ่ นักศึกษาใช้วิธีนี้ซึ่งไม่สามารถ Represent ประชากรทั้งหมดได้ เพราะ ข้อมูลจะอยู่กระจุกอยู่ที่ส่วนใดส่วนหนึ่งของทั้งหมด เช่น ออกแบบสอบถามใน google form ส่งให้เพื่อนช่วยทำ เป็นต้น
      • Snowball Sampling เช่น สำรวจคนที่ซื้องาช้าง จะได้กลุ่มคนที่เหมือนๆกัน high bias แต่อย่างน้อยก็มีข้อมูล เช่นถามคนที่รู้จักกันแล้วเซอเวย์คนนี้ต่อๆเป็นทอดๆ

    นักสถิติสมัยก่อนเวลาเก็บรวบรวมกลุ่มตัวอย่างขึ้นมาแต่ละรอบนั้นค่อนข้างลำบากเลยเกิดทฤษฎีที่มีชื่อว่า Central Limit Theorem ขึ้นมาเพื่อเป็นการบอกว่าถ้าเราทำการทดลองซ้ำไปเรื่อยๆและพล๊อตเป็นกราฟ ค่าเฉลี่ยที่ได้จะเข้าใกล้ค่าเฉลี่ยของประชากรหรือค่าเฉลี่ยที่แท้จริง(Mean Population) ทฤษฏีนี้เป็นแกนหลักของสถิติแบบ Frequentist

    Central Limit theorem

    Central Limit theorem (CLT)บอกว่าถ้าเกิดเราสุ่ม Sample ออกมาจาก Population หรือที่เรียกว่า Resampling ซ้ำหลายๆครั้งแล้วนำผลลัพท์ที่ได้จากการ Resampling มาพล๊อตเป็นกราฟ Sampling Distribution ที่ได้จะเป็น Normal Distribution ไม่ว่า Population นั้นๆจะมี Distribution แบบไหนก็ตาม

    โดย Satisfy กฏอย่างน้อย 2 ข้อนี้

    1. Sample size >= 30 ขนาดกลุ่มตัวอย่างต้องมากกว่า30
    2. Random Sampling ต้องเป็นไปในแบบสุ่ม

    Descriptive Statistic

    1. Central Tendency

    have only tree parameter to measure center of normal distribution curve center.

    • Mean
    • Median (A robust stat mean that outlier does not affect median)
    • Mode

    2. Measure Of Spread

    Is used to know spread between x that how far from mean

    • SD
    • Variance
    • Range (Max-Min)
    • IQR

    Boxplot มี 3 Quarter ซึ่งวัดจาก Percentile ของ Index of dataset

    • Q1 คือ percentile ที่ 25
    • Q2 คือ percentile ที่ 50 หรือ median
    • Q3 คือ percentile ที่ 75

    IQR คือ Q3-Q1

    +-1.5 of IQR คือ outlier

    3. Measure of Position

    • Max
    • Percentile
    • Min

    Inferential Statistics

    เครื่องมือหลักใน Inferential Statistics

    • Parameter Estimation: การใช้ข้อมูลจากตัวอย่างเพื่อประมาณค่าของพารามิเตอร์ที่สนใจของประชากร เช่น การประมาณค่าเฉลี่ยของรายได้ประชากรทั้งประเทศจากข้อมูลรายได้ของกลุ่มตัวอย่าง
      • Point Estimate: การให้ค่าประมาณเป็นค่าเดียว เช่น ค่าเฉลี่ยของตัวอย่างถูกใช้เป็นค่าประมาณของค่าเฉลี่ยประชากร
      • Confidence Interval: การให้ค่าประมาณเป็นช่วงของค่าที่มีโอกาสครอบคลุมค่าพารามิเตอร์ของประชากรด้วยระดับความเชื่อมั่นที่กำหนด เช่น “เรามีความเชื่อมั่น 95% ว่าค่าเฉลี่ยรายได้ของประชากรอยู่ในช่วง 25,000 – 30,000 บาท”
    • Hypothesis Testing: การใช้ข้อมูลจากตัวอย่างเพื่อตัดสินใจว่ามีหลักฐานเพียงพอที่จะปฏิเสธสมมติฐานเกี่ยวกับประชากรหรือไม่ เช่น การทดสอบว่ายาใหม่มีประสิทธิภาพในการรักษาโรคดีกว่ายาเก่าหรือไม่
      • สมมติฐานหลัก (Null Hypothesis)
      • สมมติฐานทางเลือก (Alternative Hypothesis)

    Reference